
SQL
Types de serveurs disponibles
Avec notre intégration SQL, vous pouvez afficher tout ce qui peut être exprimé par SQL. Plecto prend en charge les types de serveurs SQL suivants :
-
MySQL
-
PostgreSQL
-
Microsoft SQL Server 2005 ou ultérieur (y compris Azure SQL)
-
Oracle
-
Snowflake
-
BigQuery*
*processus de configuration spécifique au serveur
Détails techniques
-
Fréquence de mise à jour : Personnalisée (de chaque minute à une fois par jour)
-
Prend en charge les champs personnalisés ? Oui
-
Prend en charge les enregistrements supprimés ? Non
Fréquences de mise à jour
Notre système augmentera automatiquement la fréquence de mise à jour SQL d'une source de données, en fonction du temps passé à importer depuis votre serveur. Exemples :
-
Si la fréquence de mise à jour est définie sur 1 minute, mais que l'importation prend entre 30 et 120 secondes, Plecto ajustera la fréquence de mise à jour à 5 minutes.
-
Si la fréquence de mise à jour est définie sur 1 ou 5 minutes, mais que l'importation prend entre 120 et 180 secondes, Plecto ajustera la fréquence de mise à jour à 15 minutes.
-
Si la fréquence de mise à jour est définie sur 1, 5 ou 15 minutes, mais que l'importation prend entre 180 et 360 secondes, Plecto ajustera la fréquence de mise à jour à 1 heure.
Étape 1 : Configurez votre pare-feu
Avant d'essayer d'importer des données depuis votre serveur SQL, veuillez vous assurer de configurer votre pare-feu pour n'autoriser que le trafic provenant de la source suivante :
- 51.159.130.44
Le 28-29 juin 2025, Plecto a effectué une migration vers un fournisseur d'hébergement basé en Europe, et donc l'adresse IP indiquée ci-dessus remplace les anciennes IP de Plecto. L'adresse ci-dessus remplace les anciennes IP utilisées pour le trafic, alors veuillez vous assurer de mettre à jour votre configuration si vous ne l'avez pas encore fait.
Les adresses IP Plecto suivantes seront dépréciées après le 28 juin 2025 :
-
54.76.22.100
-
54.76.22.43
-
52.210.249.227
Étape 2 : Connectez votre serveur SQL à Plecto
Nous vous recommandons de créer un nouveau nom d'utilisateur et un mot de passe spécifiquement destinés à connecter votre base de données à Plecto. De cette façon, vous éviterez de partager le même mot de passe entre les bases de données. Cela vous permettra également de limiter les autorisations de l'utilisateur créé à un accès en lecture seulement.
-
Allez dans Sources de données > Nouvelle source de données et choisissez votre base de données.
Si vous souhaitez configurer des bases de données Amazon Athena/Redshift, consultez leurs guides d'intégration spécifiques.
-
Remplissez les informations d'identification. Si vous avez accès à la base de données, vous devriez être en mesure de rassembler vos informations d'identification.
-
Remarque sur Nom d'hôte : Vous devez fournir une IP publique. Si vous ajoutez une IP locale, la connexion ne fonctionnera pas. En savoir plus.
-
Remarque sur Nom d'utilisateur lors de la connexion avec Azure : Si vous utilisez SQL Server sur Azure, vous devez ajouter username@[hostname] dans le champ nom d'utilisateur. Par exemple, si le nom d'hôte est plecto.database.windows.net, alors vous devez écrire username@plecto.database.windows.net dans le champ nom d'utilisateur.
-
Si vous souhaitez utiliser le Tunnel SSH : SSH vous permet de transporter des données via une connexion sécurisée et cryptée. Veuillez contacter le personnel technique de votre organisation si vous souhaitez connecter votre base de données à Plecto en utilisant un tunnel SSH mais ne savez pas comment faire.
Clé privée RSA. Plecto utilise une clé privée RSA (format PEM) pour accéder à votre base de données. Vous devez générer la clé dans le système que vous utilisez, et elle doit être formatée dans Plecto comme suit :
-----BEGIN RSA PRIVATE KEY----- collez la clé ici *-----END RSA PRIVATE KEY-----
-
-
Cliquez sur Continuer et passez à l'étape 3 où vous devrez écrire une instruction SQL.
Étape 3 : Écrivez une instruction SQL
Une fois que vous avez connecté Plecto à la base de données, vous devez écrire une instruction SELECT où vous incluez les champs standards suivants :
-
member_id (obligatoire pour créer l'utilisateur, si l'ID n'est pas trouvé)
-
member_name (obligatoire pour mapper les données aux membres dans Plecto)
-
date (date obligatoire associée à cet enregistrement (toujours en UTC !))
-
reference (obligatoire identifiant unique ; peut être utilisé pour mettre à jour les enregistrements)
-
team_name (optionnel ; nous l'insérerons dans la source de données Plecto)
Procédures stockées. Plecto peut également utiliser des procédures stockées au lieu des instructions SELECT. Celles-ci doivent être utilisées avec une instruction EXEC. Veuillez noter que les procédures stockées doivent toujours inclure les champs standards mentionnés ci-dessus.
Comment limiter l'instruction SQL
Avec chaque importation, Plecto importera et mettra à jour toutes les données, y compris les lignes qui ont déjà été importées mais qui n'ont pas changé depuis la dernière exécution de l'importation. Par conséquent, soyez conscient de la quantité de données que vous devez réellement importer – plus votre configuration est optimale, plus Plecto sera en mesure de traiter vos données rapidement.
Pour accélérer les mises à jour et réduire la charge sur vos serveurs, veuillez limiter votre instruction afin qu'elle ne renvoie que les dernières données modifiées. Vous pouvez utiliser la variable {{ last_update_time }} pour filtrer les éléments qui n'ont pas été importés depuis la dernière exécution.
-
Si vous avez un champ de date, vous pouvez ajouter la fonction suivante à la clause, et la variable sera remplacée par la dernière date et heure à laquelle la source de données a été mise à jour :
date field >= {{ last_update_time }} -
Vous pouvez également ajouter une limite de date supérieure qui empêchera Plecto d'importer des données plus récentes que la limite indiquée. Utilisez la fonction suivante :
date field <= {{ upper_date_limit }} -
Vous pouvez également utiliser un top 100 dans la fonction SELECT. N'oubliez pas de trier par DESC (décroissant) pour sélectionner les enregistrements les plus récents.
last_update_time et upper_date_limit
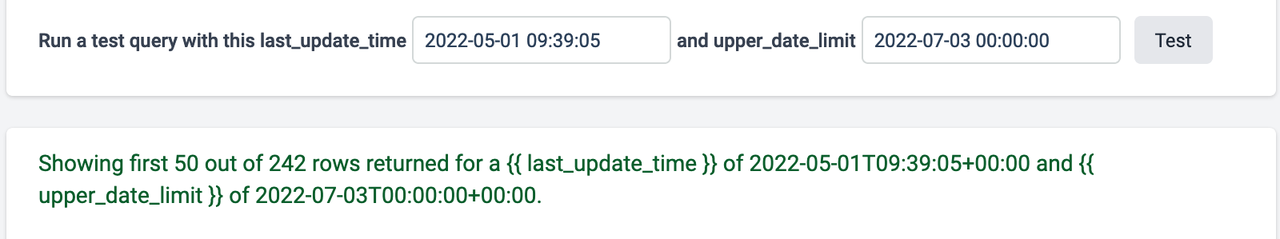
Lorsque vous écrivez une instruction SQL, vous pouvez ajouter une date de début (last_update_time) et une date de fin (upper_date_limit) qui feront que votre base de données n'importera que les données de cette période.
Vous pouvez exécuter une requête de test pour voir combien de lignes il y a pendant la période indiquée.
Source de l'ID membre
La source de l'ID membre indique à Plecto quel système est le fournisseur de données. La source de l'ID membre doit être le même nom de système que vous voyez dans la colonne Fournisseurs de données sous Paramètres > Employés. Les termes Source de l'ID membre et Fournisseurs de données font référence au même système.
Si les deux endroits ont des noms de système différents, Plecto créera de nouveaux employés avec chaque importation de données, ce qui pourrait entraîner des profils d'employés en double. Par conséquent, nous vous recommandons d'utiliser le même nom de source d'ID membre que celui de votre fournisseur de données.
Importation de données SQL
-
La requête : Écrivez une instruction SQL qui renvoie un certain nombre de lignes, chacune correspondant à un enregistrement dans notre système. Chaque ligne peut avoir n'importe quel nombre de colonnes qui seront enregistrées sur l'enregistrement.
-
Données historiques : Plecto peut importer des données historiques une fois. Ensuite, nous maintenons les données à jour en important toutes les [x] minutes, mais uniquement les lignes qui ont changé.
-
Journaux d'importation : Vous pouvez voir tous les journaux d'importation, à la fois automatiques et manuels, en cliquant sur le bouton Voir les journaux dans le coin supérieur droit des paramètres de la source de données.
-
Nouvelles données : À chaque importation, Plecto importera toutes les données. Si vous ne souhaitez voir que les données nouvelles/mises à jour, vous pouvez limiter votre instruction SQL (lisez ci-dessous). En limitant l'instruction, Plecto n'importera que les lignes qui ont changé, par exemple, au cours des 5 dernières minutes.
-
Données brutes : Plecto fonctionne mieux si vous importez des données brutes. Cela signifie qu'une ligne doit représenter un élément. Ne pas importer des indicateurs déjà calculés. Plecto peut calculer ces indicateurs à partir des données brutes en utilisant des formules.
Limite d'importation d'enregistrements sur SQL
Plecto limite le nombre d'enregistrements qui peuvent être importés par requête en fonction de la fréquence de mise à jour.
| Fréquence de mise à jour | Nombre max d'enregistrements |
|---|---|
| 1 min | 1000 |
| 5 min | 4000 |
| 15 min | 10 000 |
| 30 min | 16 000 |
| 1 heure | 20 000 |
| 2 heures | 30 000 |
| 4 heures | 40 000 |
| 8 heures | 60 000 |
| 1 jour | 100 000 |
Importation manuelle de données
À partir de juillet 2022, nos intégrations SQL prennent en charge l'importation manuelle de données.
-
Ouvrez les paramètres de la source de données et cliquez sur Importer des données historiques.
-
Choisissez les dates de début et de fin et cliquez sur Démarrer l'importation.
Gardez à l'esprit que si vous souhaitez importer beaucoup de données historiques, vous devez diviser l'importation de données en plusieurs sessions. Si vous importez beaucoup de données anciennes à la fois, la base de données pourrait ne pas être en mesure de terminer l'importation.
Les dates de début et de fin seront incluses dans l'instruction. Une fois que vous choisissez les dates de début et de fin pour l'importation manuelle de données, elles seront passées à last_update_time et upper_date_limit dans le modèle de votre instruction.