
SQL
Beschikbare server types
Met onze SQL-integratie kun je alles weergeven dat kan worden uitgedrukt door SQL. Plecto ondersteunt de volgende SQL-server types:
-
MySQL
-
PostgreSQL
-
Microsoft SQL Server 2005 of later (inclusief Azure SQL)
-
Oracle
-
Snowflake
-
BigQuery*
*server-specifiek configuratieproces
Technische details
-
Updatefrequentie: Aangepast (van elke 1 minuut tot eenmaal per dag)
-
Ondersteunt aangepaste velden? Ja
-
Ondersteunt verwijderde registraties? Nee
Updatefrequenties
Ons systeem zal automatisch de SQL-updatefrequentie van een gegevensbron verhogen, afhankelijk van de tijd die nodig is om te importeren van je server. Voorbeelden:
-
Als de updatefrequentie is ingesteld op 1 minuut, maar de import tussen 30 - 120 seconden duurt, zal Plecto de updatefrequentie aanpassen naar 5 minuten.
-
Als de updatefrequentie is ingesteld op 1 of 5 minuten, maar de import tussen 120 - 180 seconden duurt, zal Plecto de updatefrequentie aanpassen naar 15 minuten.
-
Als de updatefrequentie is ingesteld op 1, 5 of 15 minuten, maar de import tussen 180 - 360 seconden duurt, zal Plecto de updatefrequentie aanpassen naar 1 uur.
Stap 1: Configureer je firewall
Voordat je probeert gegevens van je SQL-server te importeren, zorg ervoor dat je je firewall configureert om alleen verkeer van de volgende bron toe te staan:
- 51.159.130.44
Op 28-29 juni 2025 heeft Plecto een migratie uitgevoerd naar een op Europa gebaseerde hostingprovider, en daarom vervangt het hierboven vermelde IP-adres de oude Plecto IP's. Het bovenstaande adres vervangt de oude IP's die werden gebruikt voor verkeer, dus zorg ervoor dat je je configuratie bijwerkt als je dat nog niet hebt gedaan.
De volgende Plecto IP-adressen worden na 28 juni 2025 verouderd:
-
54.76.22.100
-
54.76.22.43
-
52.210.249.227
Stap 2: Verbind je SQL-server met Plecto
We raden aan dat je een nieuwe gebruikersnaam en wachtwoord aanmaakt die specifiek bedoeld zijn voor het verbinden van je database met Plecto. Op deze manier vermijd je het delen van hetzelfde wachtwoord tussen databases. Het stelt je ook in staat om de toestemming voor de aangemaakte gebruiker te beperken tot alleen leesrechten.
-
Ga naar Gegevensbronnen > Nieuwe gegevensbron en kies je database.
Als je Amazon Athena/Redshift-databases wilt configureren, raadpleeg dan hun specifieke integratiehandleidingen.
-
Vul de inloggegevens in. Als je toegang hebt tot de database, zou je je inloggegevens moeten kunnen verzamelen.
-
Opmerking over Hostname: Je moet een publiek IP opgeven. Als je een lokaal IP toevoegt, werkt de verbinding niet. Leer meer.
-
Opmerking over Gebruikersnaam bij verbinding met Azure: Als je SQL-server op Azure gebruikt, moet je gebruikersnaam@[hostname] in het gebruikersnaamveld toevoegen. Bijvoorbeeld, als de hostname plecto.database.windows.net is, dan moet je gebruikersnaam@plecto.database.windows.net in het gebruikersnaamveld schrijven.
-
Als je de SSH Tunnel wilt gebruiken: SSH stelt je in staat om gegevens over een veilige en versleutelde verbinding te transporteren. Neem contact op met de technische staf van je organisatie als je je database met Plecto wilt verbinden via een SSH-tunnel maar niet weet hoe.
RSA privésleutel. Plecto gebruikt een RSA privésleutel (PEM-formaat) om toegang te krijgen tot je database. Je moet de sleutel genereren in het systeem dat je gebruikt, en deze moet in Plecto als volgt worden opgemaakt:
-----BEGIN RSA PRIVATE KEY----- *plak sleutel hier *-----END RSA PRIVATE KEY-----
-
-
Klik op Doorgaan en ga naar Stap 3 waar je een SQL-instructie moet schrijven.
Stap 3: Schrijf een SQL-instructie
Zodra je Plecto met de database verbindt, moet je een SELECT-instructie schrijven waarin je de volgende standaardvelden opneemt:
-
member_id (verplicht om de gebruiker te maken, als ID niet wordt gevonden)
-
member_name (verplicht om gegevens aan leden in Plecto te koppelen)
-
date (verplicht datum geassocieerd met dit record (altijd in UTC!))
-
reference (verplicht unieke identificatie; kan worden gebruikt om registraties bij te werken)
-
team_name (optioneel; we zullen het upsert in de Plecto-gegevensbron)
Opgeslagen procedures. Plecto kan ook opgeslagen procedures gebruiken in plaats van SELECT-instructies. Deze moeten worden gebruikt met een EXEC-instructie. Houd er rekening mee dat de opgeslagen procedures nog steeds de standaardvelden moeten bevatten die hierboven zijn genoemd.
Hoe de SQL-instructie te beperken
Bij elke import zal Plecto alle gegevens importeren en bijwerken, inclusief de rijen die al zijn geïmporteerd maar sinds de laatste importrun niet zijn veranderd. Wees daarom bewust van hoeveel gegevens je daadwerkelijk moet importeren – hoe optimaler je setup, hoe sneller Plecto je gegevens kan verwerken.
Om de updates te versnellen en de belasting op je servers te verlagen, beperk je instructie zodat deze alleen de laatst gewijzigde gegevens retourneert. Je kunt de variabele {{ last_update_time }} gebruiken om te filteren op items die sinds de laatste run niet zijn geïmporteerd.
-
Als je een datumveld hebt, kun je de volgende functie aan de clausule toevoegen, en de variabele wordt vervangen door de laatste datum en tijd waarop de gegevensbron werd bijgewerkt:
datum veld >= {{ last_update_time }} -
Je kunt ook een bovengrens voor de datum toevoegen die ervoor zorgt dat Plecto geen gegevens importeert die nieuwer zijn dan de aangegeven limiet. Gebruik de volgende functie:
datum veld <= {{ upper_date_limit }} -
Je kunt ook een top 100 gebruiken in de SELECT functie. Vergeet niet om DESC (aflopend) te sorteren om de nieuwste records te selecteren.
last_update_time en upper_date_limit
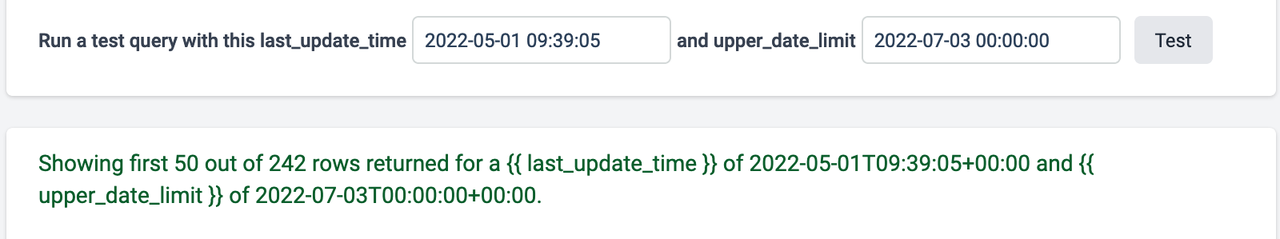
Wanneer je een SQL-instructie schrijft, kun je een startdatum (last_update_time) en einddatum (upper_date_limit) toevoegen die ervoor zorgen dat je database alleen gegevens importeert uit die periode.
Je kunt een testquery uitvoeren om te zien hoeveel rijen er zijn tijdens de aangegeven periode.
Lid ID Bron
Lid ID Bron vertelt Plecto welk systeem de gegevensleverancier is. De Lid ID Bron moet dezelfde systeemnaam zijn die je ziet in de Gegevensleveranciers kolom onder Instellingen > Werknemers. Zowel Lid ID Bron als Gegevensleveranciers verwijzen naar hetzelfde systeem.
Als beide plaatsen verschillende systeemnamen hebben, zal Plecto nieuwe werknemers aanmaken bij elke gegevensimport, wat kan leiden tot dubbele werknemersprofielen. Daarom raden we aan om dezelfde naam voor de Lid ID Bron te gebruiken als de naam van je gegevensleverancier.
SQL gegevensimport
-
De query: Schrijf een SQL-instructie die een aantal rijen retourneert, elk overeenkomend met een registratie in ons systeem. Elke rij kan een willekeurig aantal kolommen hebben die op de registratie worden opgeslagen.
-
Historische gegevens: Plecto kan historische gegevens één keer importeren. Daarna houden we de gegevens up-to-date door elke [x] minuten te importeren, maar alleen de rijen die zijn veranderd.
-
Importlogs: Je kunt alle importlogs, zowel automatisch als handmatig, bekijken door op de knop Bekijk logs in de rechterbovenhoek in de instellingen van de gegevensbron te klikken.
-
Nieuwe gegevens: Bij elke import zal Plecto alle gegevens importeren. Als je alleen de nieuwe/bijgewerkte gegevens wilt zien, kun je je SQL-instructie beperken (lees hieronder). Door de instructie te beperken, zal Plecto alleen rijen importeren die zijn veranderd, bijvoorbeeld binnen de laatste 5 minuten.
-
Ruwe gegevens: Plecto werkt het beste als je ruwe gegevens importeert. Dat betekent dat één rij één item moet vertegenwoordigen. Importeer geen reeds berekende metrics. Plecto kan deze metrics berekenen uit de ruwe gegevens met behulp van formules.
Registratie importlimiet op SQL
Plecto beperkt het aantal registraties dat per query kan worden geïmporteerd op basis van de updatefrequentie.
| Updatefrequentie | Max. aantal registraties |
|---|---|
| 1 min | 1000 |
| 5 min | 4000 |
| 15 min | 10 000 |
| 30 min | 16 000 |
| 1 uur | 20 000 |
| 2 uur | 30 000 |
| 4 uur | 40 000 |
| 8 uur | 60 000 |
| 1 dag | 100 000 |
Handmatige gegevensimport
Vanaf juli 2022 ondersteunen onze SQL-integraties handmatige gegevensimport.
-
Open de instellingen van de gegevensbron en klik op Importeer historische gegevens.
-
Kies de start- en einddata en klik op Start import.
Houd er rekening mee dat als je veel historische gegevens wilt importeren, je de gegevensimport in meerdere sessies moet splitsen. Als je veel oude gegevens in één keer importeert, kan de database mogelijk de import niet voltooien.
Start- en einddata worden opgenomen in de instructie. Zodra je de start- en einddata voor handmatige gegevensimport kiest, worden ze doorgegeven aan de last_update_time en upper_date_limit in de sjabloon van je instructie.